


 Kundservice +46 8 52 400 700


-
Produkterna
Hitta bland alla våra produkter
-
Andra sätt att hitta på
-
Andra sätt att hitta på
-
- 2mm för datacentret och 3mm för installationer ute i fält
- Bredd fiberkontakter, med eller utan dragögla
- Robust fiber
- Smartkeeper kabellås och portpluggar
- Låsbart - för funktioner du älskar
- Kabelvindan, perfekt både akut och temporärt
- Öka driftsäkerheten med en låsbar strömkabel
- Välj rätt laddkabel för elfordon
- Hur fungerar en OTDR
- Rackstuds framtidens korgmutter
- Märkning av kablar med precision och effektivitet!
Andra sätt att hitta på
-
Andra sätt att hitta på
-
- Säkerställ rätt temperatur vid kyltransport
- Säkerhetskameror
- Övervakning av större områden
- Ta ditt växthus till nästa nivå
- Butiksövervakning
- Temperaturövervaka butiken med WiFi-sensorer
- Rätt luftkvalite på din arbetsplats
- Varningsljus i trafikens tjänst
- RFID-integrerade etiketter
- Övervakning och Kontrollrum
- Överfulla soptunnor, inte längre ett problem
Andra sätt att hitta på
-
- AV över IP – strömmande media via Ethernet
- Videoväggar & digital skyltning
- Broadcasting – produktion och bearbetning med krav på bandbredd
- Telemedicin – höga krav på snabb kommunikation av ljud och bild
- AV-presentation – Professionell konferensteknik via fiber
- Fiberburet AV – strömmande media via fiber
Andra sätt att hitta på
-
Andra sätt att hitta på
-
Andra sätt att hitta på
-
Andra sätt att hitta på
-
Andra sätt att hitta på
-
-
- ...
- Startsida
- Kunskapsbanken
- Maximal framkomlighet i nätverket
- Så överlever nätverket en avgrävd fiberlänk!
Maximal framkomlighet i nätverket
-
Nätverk

-
Koaxkabel och kontakter
-
SFP för alla behov
-
Energisystem och laddning
-
Datacenter och serverhallar
-
IP-larm och fjärrkontroll
-
Test och verifiering
-
Ergonomi och komfort
-
Maximal framkomlighet i nätverket
-
Tryggare miljöer
-
Kundanpassade lösningar
-
IoT - Internet of Things
-
Tillbehör och gränssnitt
-
Märkning och Etikettering
-
AV över IP
-
Strömförsörjning
-
Standardisering och certifiering
-
Elektromekanik
Så överlever nätverket en avgrävd fiberlänk!
I ett robust Ethernet-nät räcker det inte att ha en extra fiberlänk. Nätverket måste också kunna upptäcka att den ordinarie länken har försvunnit och aktivera reserven utan att skapa en nätverksloop. Dessutom behöver det ske tillräckligt snabbt för att användare och programvaror ska påverkas så lite som möjligt.
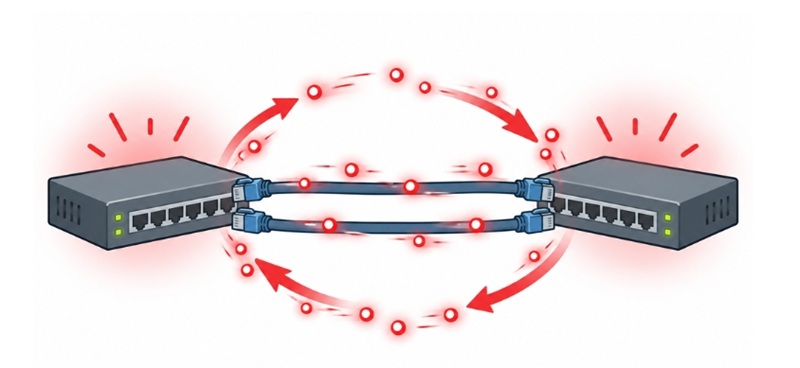
Dubbla länkar kan skapa förödande loop
Man kan lätt tro att två kablar är bättre än en mellan switcharna. Då dubblar man väl hastigheten och får en back-up om den ena kopplas ur eller går sönder, eller? Testa så får du se, men bara då du är ensam på kontoret om du vill ha jobbet kvar :-)
I praktiken är det inte en bra ide. Du skapar nämligen en sk Layer 2-loop vilket blir katastrofalt väldigt snabbt eftersom Ethernetpaketen ekas mellan switcharnas båda portar i en oändlig loop vilket snabbt fyller upp länkarna, belastar switcharnas CPU och gör nätverket i praktiken oanvändbart. Den här effekten är inte isolerad till endast de två switcharna som är felaktigt loopade, utan kan påverka alla switchar och enheter inom samma Layer 2-domän, normalt samma VLAN. Så vare sig det rör sig om koppar- eller fiberkabel ger dubbla länkar inte automatiskt redundans.
(Undantaget är om länkarna medvetet konfigureras som en gemensam länkgrupp, exempelvis med LACP (länk-aggregering). Då behandlas de som en logisk förbindelse och kan ge både redundans och högre sammanlagd kapacitet.)
Det är här tekniker som Spanning Tree, RSTP, MSTP och Ethernet Ring Protection Switching (ERPS) kommer in i bilden.
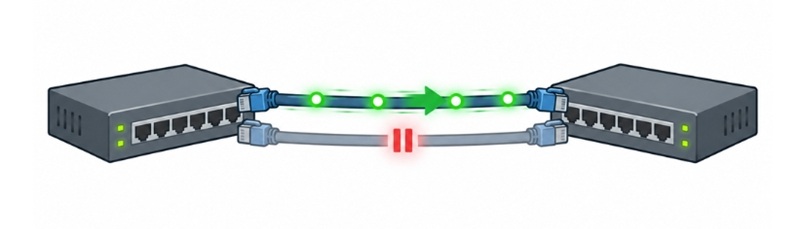
Reservlänk utan loop
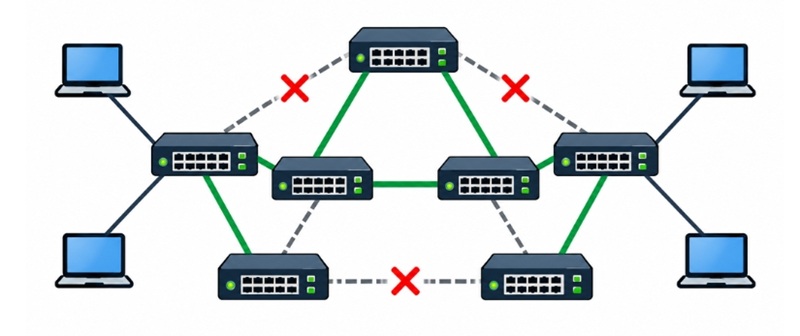
Ethernet är alltså känsligt för loopar. Broadcast- och multicasttrafik börjar cirkulera runt nätet, MAC-tabeller blir instabila och nätverket kan snabbt bli överbelastat. Därför måste redundanta Ethernet-nät normalt hålla någon del av reservvägen blockerad. När ett fel uppstår aktiveras den alternativa vägen på ett kontrollerat sätt.
Det är alltså inte den extra fibern i sig som skapar redundansen. Det är kombinationen av fysisk reservväg och ett protokoll som styr trafiken vid fel.
Spanning Tree - den generella lösningen
Spanning Tree utvecklades för att göra det möjligt att bygga Ethernet-nät med flera fysiska vägar utan att skapa loopar. Switcharna väljer en logisk, loopfri topologi där vissa länkar används och andra hålls blockerade. Om en aktiv förbindelse går ner kan nätverket räkna om topologin och använda en tidigare blockerad väg. I moderna nät används framför allt RSTP (Rapid Spanning Tree Protocol) och MSTP (Multiple Spanning Tree Protocol).
Spanning Trees stora styrka är flexibiliteten. Nätet behöver inte vara en ring utan kan ha mer komplexa topologier med många redundanta länkar. Samtidigt innebär flexibiliteten att switcharna behöver avgöra hur den nya topologin ska se ut när ett fel inträffar.
Hur snabbt detta sker är lite svårare att ge ett exakt svar på då dessa konfigurationer kan byggas mer komplext. Generellt kan man säga att klassisk Spanning Tree kan behöva tiotals sekunder för att återställa nätet efter ett fel. RSTP och MSTP är betydligt snabbare och kan i gynnsamma fall växla in reservlänken på under en sekund, men den faktiska tiden beror på feltyp, topologi och implementation.
Cisco skriver exempelvis "The RSTP takes advantage of point-to-point wiring and provides rapid convergence of the spanning tree. Reconfiguration of the spanning tree can occur in less than 1 second (in contrast to 50 seconds with the default settings in the IEEE 802.1D spanning tree)." i sin "Layer 2 Configuration Guide" för Catalyst 9300-serien.
Juniper å andra sidan skriver "Where STP took up to 50 seconds to respond to topology changes, RSTP responds to changes within the timeframe of three hello BPDUs (bridge protocol data units), or 6 seconds." i sin Spanning-Tree Protocols User Guide från 2025.
ERPS – när nätverket är byggt som en ring
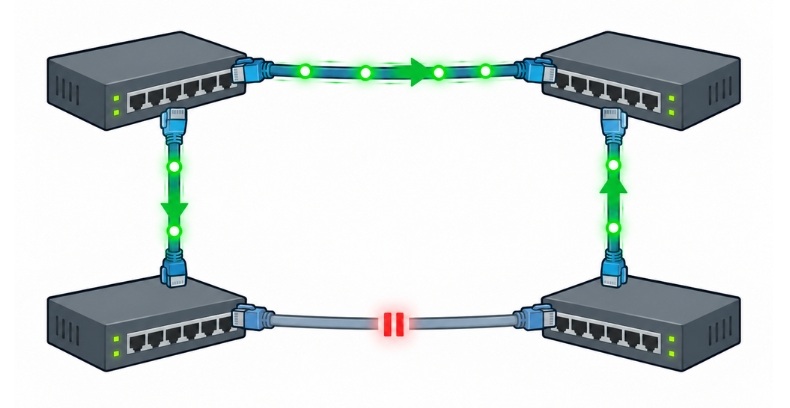
När nätet medvetet byggs som en ring finns en mer specialiserad lösning: Ethernet Ring Protection Switching, ERPS, enligt ITU-T G.8032. ERPS utgår från att nätet redan har en känd ringtopologi. En del av ringen hålls normalt blockerad för att förhindra loopar.
Anta exempelvis att nätverket består av fyra switchar och är kopplade i en ring på detta vis:
A — B — C — D — A
Om länken mellan D och A normalt är blockerad går trafiken från A till D via B och C.
Om fibern mellan B och C grävs av upptäcker switcharna felet och ERPS öppnar den tidigare blockerade vägen mellan A och D. Trafiken kan då gå:
B → A → D → C
Nätverket har gått från en hel ring till en öppen ring, men kommunikationen kan fortsätta.
Detta är ett exempel på vad som ibland kallas deterministisk Layer 2-redundans. Nätet vet redan hur ringtopologin ser ut, vilken väg som normalt är blockerad och hur trafiken ska styras om när ett fel inträffar. Därför kan också reservlänken kopplas in betydligt snabbare.
Vad händer egentligen när fibern går av?
Från själva kabelbrottet till återställd kommunikation måste flera saker ske. Först måste felet upptäckas. Det kan ske genom att den fysiska länken går ner. Därefter måste switcharna informeras om topologiförändringen. I ERPS används R-APS, Ring Automatic Protection Switching, för att koordinera detta.
Sedan behöver den alternativa vägen öppnas samtidigt som nätverket säkerställer att ingen loop uppstår. Slutligen kan switcharnas MAC-tabeller behöva uppdateras. Om en MAC-adress tidigare nåddes via en port men efter fiberbrottet finns i andra riktningen måste switcharna snabbt uppdatera sina "adresslistor".
Det är summan av dessa steg som avgör den verkliga återställningstiden.
Varför talas det om 50 millisekunder?
ERPS förknippas ofta med mycket snabb överkoppling till reservlänken. G.8032 är utformat för att kunna ge återställningstider kring eller under 50 millisekunder under optimala förutsättningar (färre än 16 ringnoder och under 1200 km fiberomkrets). Det betyder dock inte att varje produkt med texten ”ERPS support” automatiskt garanterar samma resultat i alla nät.
Den verkliga tiden påverkas bland annat av hur snabbt felet upptäcks, hur många noder som finns i ringen och hur snabbt MAC-tabeller kan uppdateras. Därför bör man skilja mellan stöd för protokollet och verifierad failover-prestanda. I nät där kort avbrottstid är viktig bör man därför testa systemet praktiskt: dra ur fibern eller bryt strömmen till en nod och mät hur länge trafiken faktiskt störs.
ERPS eller Spanning Tree?
Det ena är inte generellt bättre än det andra. Spanning Tree passar väl när nätet har en generell Layer 2-topologi med flera redundanta vägar. ERPS passar särskilt bra när nätet medvetet byggs som en ring och man vill ha en snabb och förutsägbar skyddsmekanism.
Spanning Trees styrka är alltså flexibilitet, medan ERPS styrka är specialisering på ringtopologier. Det är också fullt möjligt att använda teknikerna i olika delar av samma nät.
Kräver ERPS en kraftigare switch?
Inte nödvändigtvis. När nätverket fungerar normalt switchas användartrafiken fortfarande i switchens forwarding-hårdvara. Själva ERPS-protokollet behöver inte innebära någon stor kontinuerlig processorbelastning. Det som kan ställa högre krav är den snabba felhanteringen. Switchen måste kunna upptäcka fel, ändra forwarding-state och uppdatera relevanta tabeller mycket snabbt. Av den anledningen kan två switchar som båda stöder G.8032 prestera olika vid ett verkligt fel.
ERPS förekommer därför ofta i produkter som är utvecklade för stadsnät, industri, energi, transport och andra miljöer där hög tillgänglighet är viktig. Det betyder inte nödvändigtvis att ERPS i sig kräver dyr hårdvara, utan snarare att produkten är byggd och testad för den typen av användning.
Den fysiska vägen är minst lika viktig
Ingen redundansmekanism kan kompensera för en dåligt byggd fiberinfrastruktur. Två fiberförbindelser kan se redundanta ut i nätverksdiagrammet men ändå ligga i samma kabel eller samma kabelrör. En enda grävskada kan då kapa båda förbindelserna samtidigt.
Verklig redundans kräver därför att man tittar på hela kedjan: switchportar, optiska moduler, patchning, fiberkablar, kanalisation, strömförsörjning och de noder som trafiken passerar. Även reservvägens kapacitet måste vara tillräcklig. Om all trafik normalt är fördelad över flera länkar måste den kvarvarande vägen kunna bära lasten när ett fel inträffar.
I slutänden handlar ett robust nät inte om att förhindra alla fel. Fiber kommer att grävas av, optiska moduler kommer att gå sönder och switchar kommer ibland att tappa ström. Målet är i stället att göra konsekvensen av ett fel så liten, kortvarig och förutsägbar som möjligt.
Hör av dig till oss om du vill diskutera redundans och framkomlighet i nätverket, vi är lätta att nå och svarar direkt på chatt, mail eller telefon: 08 52 400 700.
Missa heller inga artiklar i Kunskapsbanken, prenumerera på nyhetsbrevet
© Copyright 2026-10-05, innehållet är skyddat enligt lagen om upphovsrätt.

Relevanta produkter


